Piotr Wozniak,1990年
本文摘自P.A. Wozniak于1990年在波兹南理工大学完成的硕士论文《学习的优化》,并经调整后作为独立文章发布在网上。(P.A. Wozniak,1998年9月17日)
我没有继续改进SM-4算法采用的数学工具,而是决定重塑修改最优间隔函数这一概念。
先忽略较小的低效问题,更仔细地考察SM-4算法的主要缺陷:
- 复习过程中,可能把某个间隔算得比前一次还短。这显然与SuperMemo方法所依据的一般假设不一致。而且,SM-5算法的应用结果也否定了这种结果的有效性,见后文。可以通过禁止间隔超出某些上下限来防止这种故障,但这种做法会给最优间隔增加多余依赖,严重减慢优化过程。实际在某个知识库中,就观察到了这种情况。尽管所涉间隔只有两周,直到SM-4使用期结束,这种不一致也没有消除。
- 具体条目的E因子不断修改,见SM-4算法第6步,因此条目可能在OI矩阵中从一个难度类别移到另一个类别。如果该条目的复习次数已经足够多,就会严重扰乱复习过程。注意,复习次数越多,相邻E因子类别列中最优间隔的差别越大。因此,E因子上升时,所用最优间隔可能被人为拉得过长;反过来,则可能过短。
SM-4算法试图把最优间隔长度与复习次数联系起来。这似乎不正确,因为记忆更可能对上一次使用的复习间隔长度敏感,而不是对复习次数敏感。前一次间隔反映在记忆强度中,而复习次数显然没有被编码,见《包含SuperMemo理论要素的记忆分子模型》。
基于以上原因,我决定用最优因子矩阵,即OF矩阵,而不是OI矩阵,来表示最优间隔函数,见图3.3。
图3.3。
新采用的最优间隔函数形式如下:
I(n,EF)=OF(n,EF)*I(n-1,EF) I(1,EF)=OF(1,EF)
其中:
I(n,EF):E因子等于EF的条目的第n个复习间隔,以天为单位。 OF(n,EF):OF矩阵中对应第n次复习和E因子EF的单元格。
根据此前的观察,OF矩阵的值不允许低于1.2,参见SM-2算法的表述。
容易看出,应用OF矩阵消除了SM-4算法的上述两个缺点:
- 后续复习的间隔不会变短,每一个都至少是前一个的1.2倍。
- 改变E因子类别时,下一次间隔只会按OF矩阵中相应单元格要求的倍数增长。
下面给出SuperMemo 5所用算法的最终形式,即SM-5算法: 1. 把知识拆成尽可能小的条目。 2. 为所有条目设置等于2.5的E因子。 3. 针对不同复习次数和E因子类别,把OF矩阵列成表格,见图3.3。采用以下公式: OF(1,EF):=4 当n>1时,OF(n,EF):=EF 其中,OF(n,EF)为对应第n次复习和E因子EF的最优因子。 4. 用OF矩阵确定复习间隔: I(n,EF)=OF(n,EF)*I(n-1,EF) I(1,EF)=OF(1,EF) 其中,I(n,EF)为E因子等于EF的条目的第n个复习间隔,以天为单位;OF(n,EF)为OF矩阵中对应第n次复习和E因子EF的单元格。 5. 每次复习后,用0至5的范围评估作答质量,参见SM-2算法。 6. 每次复习后,根据以下公式修改刚复习条目的E因子: EF’:=EF+(0.1-(5-q)*(0.08+(5-q)*0.02)) 其中,EF’为新E因子,EF为旧E因子,q为0至5范围内的作答质量。如果EF小于1.3,就设为1.3。 7. 每次复习后,修改OF矩阵中对应的单元格。可以人为构造如下示例公式,SuperMemo 5.3实际所用公式见图3.4: OF’:=OF*(0.72+q*0.07) OF”:=(1-fraction)*OF+fraction*OF’ 其中,OF”为OF单元格新值;OF’为计算使用的辅助值;OF为旧值;fraction为0与1之间的数,越大,OF矩阵变化越快;q为0至5范围内的作答质量。 注意,q=4时,OF不变;q>4时增加,q<4时减少。请查看图5所示过程,避免过度简化的陷阱。 8. 如果作答质量低于3,就从头开始复习该条目,不改变E因子。 9. 每天复习会话结束后,再次复习所有质量评分低于4的条目,直到它们全部至少达到4。
图3.4:SuperMemo 5.3中,每次复习后计算新最优因子的过程。为清楚起见做了简化,但不显著改变计算过程。
procedure calculate_new_optimal_factor; 输入: interval_used:当前条目上次使用的间隔。 quality:复习作答质量。 used_of:计算当前条目上次间隔所使用的最优因子。 old_of:对应当前条目复习次数和E因子的OF单元格旧值。 fraction:位于(0,1)的数,决定修改速度;越大,OF矩阵变化越快。 输出: new_of:当前OF矩阵单元格新计算出的值。 局部变量: modifier:决定OF值按多少倍增加或减少的数。 mod5:q=5时建议采用的modifier值。 mod2:q=2时建议采用的modifier值。 begin mod5:=(interval_used+1)/interval_used; if mod5<1.05 then mod5:=1.05; mod2:=(interval_used-1)/interval_used; if mod2>0.75 then mod2:=0.75; if quality>4 then modifier:=1+(mod5-1)*(quality-4) else modifier:=1-(1-mod2)/2*(4-quality); if modifier<0.05 then modifier:=0.05; new_of:=used_of*modifier; if quality>4 then if new_of<old_of then new_of:=old_of; if quality<4 then if new_of>old_of then new_of:=old_of; new_of:=new_of*fraction+old_of*(1-fraction); if new_of<1.2 then new_of:=1.2; end;
3.5. 最优间隔的随机分散
为进一步改进优化过程,我们引入一种看似违背最优重复间隔原则的机制。重新考察SM-5的一个重要缺陷:对最优因子的修改,只有在以下条件满足之后,才能验证其是否正确:
- 修改后的因子被用于计算某个复习间隔。
- 计算出的间隔已经过去,完成一次复习,并得到可能提示需要增大或减小最优因子的作答质量。
这意味着,即使用大量实例修改某个最优因子,在新值被用于确定新的间隔、并等到间隔过去而验证之前,它也不会显著改变。
在把修改后的最优因子用于复习、并经过必要等待时间之后验证它的过程,下文称为“修改—验证周期”。复习次数越多,修改—验证周期越长,优化过程减慢得越明显。
为说明修改限制的问题,考虑图3.4中的计算。
容易得知,当INTERVAL_USED大于20,且QUALITY等于5时,MOD5等于1.05。因为QUALITY=5,MODIFIER等于MOD5,也就是1.05。因此,新建议的最优因子值NEW_OF,只能比此前值高5%,即NEW_OF:=USED_OF*MODIFIER。只要USED_OF不增加,修改后的最优因子就永远无法突破5%的上限。而增加USED_OF,就相当于把修改后的最优因子用于计算复习间隔。
考虑到这些事实,我决定在某些情况下,允许复习间隔偏离最优值,以绕开修改—验证周期施加的限制。
我把随机修改最优间隔的过程,称为分散。
如果允许少量间隔比OF矩阵所要求的更短或更长,这些偏离间隔就能加快最优因子的变化,让它们突破图3.4机制的上限而升高或下降。换句话说,如果某个最优因子的值与理想值相差很大,由偏离间隔造成的偶然变化,就不会被标准复习的数据流抵消,因为作答质量更可能促进这种变化,而不是与之对抗。
让间隔分布在最优值周围,还有一个好处:消除用户常抱怨的复习计划“成团”问题。所谓成团,就是复习任务集中在某些天,相邻日子却相对轻松。这是因为学习者经常在一次会话中记住大量条目,而这些条目在后续几个月里往往仍聚在一起,只根据E因子略作分离。
把间隔分散到最优值周围,就能消除成团问题。现在考察最新SuperMemo软件在最优值附近分散间隔时使用的公式。与OF矩阵认为最优的间隔略有不同的复习间隔,称为近似最优间隔,按下式计算:
NOI=PI+(OI-PI)*(1+m)
其中:
NOI:近似最优间隔。 PI:前一次使用的间隔。 OI:从OF矩阵计算的最优间隔,参见SM-5算法。 m:位于[-0.5,0.5]范围内的数,见下文。
或者,使用OF值:
NOI=PI*(1+(OF-1)*(1+m))
修改量m决定偏离最优间隔的程度,m=-0.5或0.5时偏离最大,m=0时完全不偏离。
一方面,要加速优化并消除成团,两者都要求较强的间隔分散;另一方面,要保持高保持率,又要求严格采用最优间隔。为取得折中,大多数情况下,m应接近零。
以下公式用于确定修改量m的分布函数:
- 选择位于[0,0.5]范围内修改量的概率,应等于0.5:
从0到0.5对f(x)dx积分,结果等于0.5。
- 假定选择m=0的概率,是选择m=0.5概率的100倍:
f(0)/f(0.5)=100
- 假定概率密度函数为负指数形式,参数a与b根据前两个方程确定:
f=a*exp(-b*x)
当m用百分数表示时,上述公式给出a=0.04652、b=0.09210。
从分布函数:
从-m到m对a*exp(-b*abs(x))dx积分,结果等于P,其中P表示概率。
可得到修改量m的值,对于m>=0:
m=-ln(1-b/a*P)/b
因此,计算近似最优间隔的最终过程如下:
a:=0.047; b:=0.092; p:=random-0.5; m:=-1/b*ln(1-b/a*abs(p)); m:=m*sgn(p); NOI:=PI*(1+(OF-1)*(100+m)/100);
其中:
random:在[0,1)范围内按均匀概率分布返回数值的函数。 NOI:近似最优间隔。 PI:此前使用的间隔。 OF:OF矩阵中相应单元格的值。
3.6. 改进预先设定的最优因子矩阵
用于变换OF矩阵的优化过程,效率令人满意,OF单元格的值能很快收敛到最终值。
不过,在所考察的1989年10月17日至1990年5月23日期间,似乎只有修改—验证周期较短,即小于3至4个月的最优因子,达到了平衡值。
还需要几年,才能更有依据地判断OF矩阵的最终形状。分析使用七个月的OF矩阵后,最有趣的明显发现是:E因子等于2.5时,第一次复习间隔应长达5天;E因子等于1.3时,甚至应长达8天!第二次间隔的对应值,则分别约为3周和2周。
新获得的最优间隔函数,可以表述为:
I(1)=8-(EF-1.3)/(2.5-1.3)*3 I(2)=13+(EF-1.3)/(2.5-1.3)*8 当i>2时,I(i)=I(i-1)*(EF-0.1)
其中:
I(i):第i次复习后的间隔,以天为单位。 EF:当前条目的E因子。
为加速优化过程,应使用这个新函数确定OF矩阵的初始状态,即SM-5第3步。除第一次间隔外,新函数与SM-0至SM-5算法所用函数没有显著区别。有人可能把这个事实归因于优化过程效率不足,毕竟预设OF矩阵会带来先入影响。为了确认并非如此,我请三位同事使用实验版SuperMemo 5.3,其中采用取值统一的OF矩阵:两个实验的全部值均为1.5,另一个实验全部为2.0。
虽然实验知识库仅使用2至4个月,OF矩阵似乎正在缓慢收敛到采用预设矩阵时得到的形式。不过,预设矩阵继承了E因子与相应E因子类别下OF单元格值之间的人为相关性,即n>3时,OF(n,EF)接近EF。取值统一的矩阵中,没有出现这一现象,它们会使OF矩阵更紧密地适应算法中人为选定要素提出的要求,例如始终为2.5的E因子初值,以及复习后修改E因子的函数等。
3.7. 在最优因子矩阵中传播变化
注意到前文提到的OF矩阵单元格关系规律后,我决定通过在矩阵中传播修改,来加速优化。如果某个最优因子增加或减少,可以推断,对应更高复习次数的OF因子,也应增加。
这一点来自关系OF(i,EF)=OF(i+1,EF),对所有E因子以及i>2大致成立。类似地,记住i>2时有OF(i,EF’)=OF(i,EF”)*EF’/EF”,特别是EF’与EF”足够接近时,就能考虑因子的理想变化。我只在OF矩阵中尚未被复习反馈修改的部分传播变化。对于前面所述实验版SuperMemo中采用的统一取值OF矩阵,这尤其成功。
建议的传播方案,可以概括如下:
1. 执行SM-5第7步后,找出OF矩阵中所有尚未在复习过程中修改的相邻单元格,即尚未进入修改—验证周期的单元格。这里相邻指复习次数相差±1、E因子类别相差±1,即E因子相差±0.1的单元格。
2. 当以下任一关系不成立时,修改相邻单元格:
- 对于i>2,所有EF都应满足OF(i,EF)=OF(i+1,EF)。
- 对于i>2,OF(i,EF’)=OF(i,EF”)*EF’/EF”。
- 对于i=1,OF(i,EF’)=OF(i,EF”)。
修改后,应当满足选定的关系。
3. 对第2步修改的全部单元格,再次查找尚未修改的相邻单元格,重复整个过程。
如果记住最优间隔函数依赖以下参数,就会发现变化传播似乎不可避免:
- 学习者的能力。
- 学习者的自我评价习惯,因为作答质量来自学习者的主观判断。
- 所记忆知识的性质等。
因此,不可能提供一个理想的预设OF矩阵,让人不再需要修改—验证过程,以及程度稍低一些的传播方案。
3.8. SM-5算法的评估
SM-5算法自1989年10月17日起使用。在高效确定所需最优间隔函数、从而提高知识获取速率方面,效果超出全部预期:9个月学会15000个条目。图3.5表明,获取速率至少是SM-2与SM-4结合使用时的两倍!
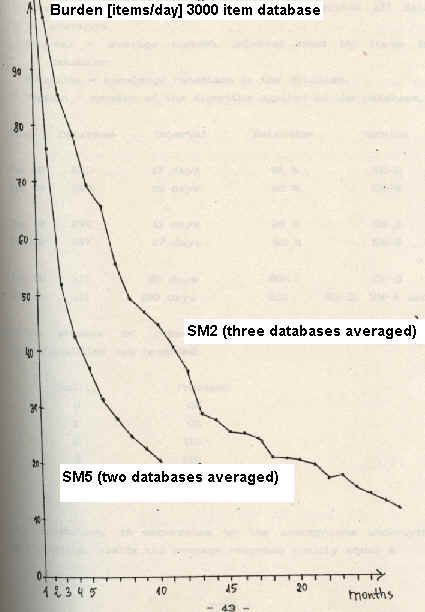
图3.5。
使用10个月的知识库,知识保持率提高到约96%。下面列出一些选定知识库的保持率数据,以比较SM-2与SM-5:
日期:测量日期。 知识库:知识库名称,ALL表示所有知识库的平均值。 间隔:知识库条目当前采用的平均间隔。 保持率:知识库中的知识保持率。 版本:知识库采用的算法版本。
| 日期 | 知识库 | 间隔 | 保持率 | 版本 |
|---|---|---|---|---|
| 1988年12月 | EVD | 17天 | 81% | SM-2 |
| 1989年12月 | EVG | 19天 | 82% | SM-5 |
| 1988年12月 | EVC | 41天 | 95% | SM-2 |
| 1989年12月 | EVF | 47天 | 95% | SM-5 |
| 1988年12月 | 全部 | 86天 | 89% | SM-2 |
| 1989年12月 | 全部 | 190天 | 92% | SM-2, SM-4 and SM5 |
复习过程中,记录到以下作答质量分布:
| 质量评分 | 占比 |
|---|---|
| 0 | 0% |
| 1 | 0% |
| 2 | 11% |
| 3 | 18% |
| 4 | 26% |
| 5 | 45% |
按照SM-5算法的基本假设,这种分布对应平均作答质量为4。遗忘指数等于11%,因为质量低于3的条目视为已遗忘。注意,保持率数据表明,知识库中只有4%的条目没有被记住,因此,遗忘指数是遗忘条目占比的2.7倍。
在使用七个月的知识库中,70%的条目在测量前的复习过程中一次都没有忘记,只有2%的条目忘记超过3次。至于修改最优间隔函数的算法的收敛情况,现在作出定论还太早,见图3.6。
图3.6。
图3.6:对于修改—验证周期较短的单元格,OF矩阵的变化。
第4章可以找到有关持续八个月SuperMemo学习过程的以下统计数据:
- E因子分布。
- 当前间隔分布。
- 最优因子矩阵。
- 最优间隔矩阵的等价形式,基于OF矩阵计算。