Piotr A. Wozniak 博士,SuperMemo World 研发部,波兰波兹南;Edward J. Gorzelanczyk 博士,波兰比得哥什大学助理教授;Janusz A. Murakowski 博士,美国特拉华大学助理教授。2005年春。
本文是论文《长期记忆双成分模型:描述不同回忆水平下记忆稳定性增加的符号公式》的通俗版本,原论文发表于“生物系统的控制论建模”会议。这里特别强调,SuperMemo 如何收集数据,帮助完善长期记忆双成分模型。文章也增加了一些实践结论,可能影响 SuperMemo 用户的学习策略。
1 记忆的 S/R 模型
十年前,我们发表论文,区分长期记忆的两个成分:稳定性与可提取性[Wozniak、Gorzelanczyk、Murakowski,1995]。论文首次勾勒了所谓 S/R 模型,使长期记忆分子模型更容易建立。迄今,这种区分尚未对本领域研究产生重大影响。这里再次强调 S/R 模型的重要性,并总结过去十年完善模型的发现,说明它如何有助于解析记忆与学习研究中看似矛盾的结果。
2 为什么需要两个变量描述长期记忆?
在记忆与学习文献中,经常遇到定义不清的“记忆强度”,或“突触连接强度”。不过,观察人脑怎样吸收信息,就会发现,至少需要两个独立变量,才能表示所谓记忆强度。一方面,复习过某个知识点后,我们记得很好,可以说“复习之后,记忆很强”。另一方面,某条信息在记忆里保留多年,即使有时回想会犹豫,我们也会说“对这个事实的记忆很强”。两种情况下,说的是不同现象,却都叫记忆强度。为了避免研究中的矛盾结果,把它们分开至关重要。我们为长期记忆的两个成分,提出了不同名称[Wozniak、Gorzelanczyk、Murakowski,1995]:
- 记忆可提取性,决定提取,也就是回忆一条记忆痕迹有多容易。
- 记忆稳定性,决定一条痕迹能在记忆中保留多久,也就是多久不被遗忘。
3 记忆变量的直观解释:可提取性与稳定性
长期记忆的可提取性与稳定性,都可以与许多分子或行为变量相关。不过,为了后续分析,我们提出两个直观度量:
- 把可提取性 R 表示为从记忆中提取一条信息的概率。虽然测量某个具体信息时,实际概率通常接近1或0,近似底层神经传递的“全或无”特征,但这个定义适合研究记忆痕迹群体。在相互独立的记忆群体中,每个记忆印迹在单位时间内遗忘的概率恒定,造成印迹不断减少。如果知道衰减函数,就能估计给定均质群体中,一条信息在某时刻被回忆的概率。后面会说明,可提取性随时间的函数,可以用指数衰减 R=e^(-d*t) 很好地近似,其中 t 为时间,d 为该均质记忆痕迹群体的衰减常数。
- 把稳定性 S 表示为使可提取性降到0.9的复习间隔。虽然分子层面的稳定性可能缓慢漂移,这个直观定义,却把它设为两次复习之间的常数。这个假定有效,因为我们只关心复习时的稳定性及其增加。
这两个直观解释,使我们更容易进一步用数学描述:长期记忆变量如何依据练习模式,也就是复习的时间安排,随时间变化。
可提取性的变化,表示为:
- (3.1) R=e^(-d*t)
其中:
- t:时间;
- R:时刻 t 的回忆概率,也就是可提取性;
- d:取决于稳定性的衰减常数。
可以用不依赖稳定性的常数 k,替换依赖稳定性的 d:
- (3.2) R=e^(-k*t/S)
其中:
- t:时间;
- R:时刻 t 的回忆概率;
- S:稳定性,以使可提取性达到90%,即 R=0.9,的复习间隔表示;
- k:不依赖稳定性的常数。
现在可以求出 k。按照稳定性 S 的定义,在 t=S 时,可提取性 R=0.9:
- (3.3) 0.9=e^(-k*S/S)
- (3.4) ln(0.9)=-k
- (3.5) k=ln(10/9)
本文将经常使用公式3.2和3.5。
4 记忆经过优化,以适应环境的概率特性
20世纪80年代,人们提出,可以通过研究环境事件推导记忆特性[Anderson 与 Schooler,1991]。这一主张的指导直觉是:记忆应反映环境的概率特性。考虑到进化可以相对容易地调整分子记忆属性,通过在不滥用容量的前提下,最大化有用信息存储,来优化生存,这种反映很有可能。
研究者从《纽约时报》中某些关键词的出现模式等研究,得出了有趣结论。如果记忆“强度”反映再次遇到某个词的概率,就可以推断:反映强度下降的遗忘,最好应为时间的幂函数,而不是大多数论文推断或假定的指数函数。
仔细看看《纽约时报》的例子,说明区分可提取性与稳定性,怎样帮助解释 Anderson 的工作。
把每个记忆事件视为伯努利试验,就能用二项分布,研究事件频率、再次出现间隔与遇见概率之间的关系。《纽约时报》中词语的出现,也适用。试验次数大、事件概率低,这里即关键词频率低,时,可以用泊松分布近似二项分布,并看到:Anderson 观察到,词语再次出现的概率,与距上次出现时间间隔之间呈幂关系,必然正确。换句话说,再次出现的概率,与距上次出现的间隔的倒数成正比。看起来,幂函数足以反映事件重现概率。因此,负幂曲线似乎是一个有充分进化理由的候选,可以反映优化良好的记忆系统中的遗忘。
然而,和当时及现在的大多数研究者一样,Anderson 依赖定义不清的记忆强度概念。如果明确区分 R 与 S,会怎样?究竟哪一个反映环境的概率特性?R 是“删除计时器”,测量自上次出现那个唤起待巩固记忆的刺激之后,经过的时间。如果平均出现率,与距上次出现的间隔成反比,回忆概率就应呈负幂下降。不过,出现率与可提取性似乎没有相关性。每次遇见或复习之后,回忆概率都重新升到1,不取决于刺激实际出现的频率!此外,如果回忆与1/t成正比,t 趋近0时,就会趋近无穷。可提取性显然不反映再次遇到刺激的概率。记忆系统只是用它,为记忆痕迹的寿命计时。更重要、更常见的刺激,寿命较长;但表达 R 的遗忘曲线,并不反映再遇概率。后文将论证:尽管人们预期它是负幂函数,遗忘曲线本质上却是负指数。
那么,稳定性符合 Anderson 的主张吗?稳定性是出现率一个很扎实的度量。每次再次遇到刺激,都会提高稳定性。如果再次把刺激流视为泊松过程,就可以预期,在第 r 次复习时,再遇概率与稳定性按如下方式增加:
- (4.1) P_(r)(N_(t)=0)=e^(-a)r^(*)^(t)
- (4.2) P_(r+1)(N_(t)=0)=exp(-a_(r)*(r/(r-1))*t)
- (4.3) ln(P_(r+1)(N_(t)=0))=(ln(P_(r)(N_(t)=0))/t)*r/(r-1)*t=ln(P_(r)(N_(t)=0))*r/(r-1)
- (4.4) P_(r+1)(N_(t)=0)=P_(r)(N_(t)=0)^^((r/(r-1)))
- (4.5) P_(r+1)(N_(t)>0)=1-(1-P_(r)(N_(t)>0))^^((r/(r-1)))
其中:
- t:时间;
- P_(r)(N_(t)=0):第 r 次复习之前,在时间 t 内没有遇见的概率;
- P_(r+1)(N_(t)>0):第 r 次复习之后,在时间 t 内遇见的概率;
- a_(r):第 r 次复习之前的平均遇见率。
把稳定性的增加记为 SInc,并期望它与遇见概率的增加匹配,则:
- (4.6) SInc=P_(r+1)(N_(t)>0)/P_(r)(N_(t)>0)
- (4.7) SInc=(1-(1-P_(r))^(^(r/(r-1))))/P_(r)
当 r=2 时:
- (4.8) SInc=(1-(P_(r)^(2)-2P_(r)+1))/P_(r)=(-P_(r)^(2)+2P_(r))/P_(r)=-P_(r)+2
P_(r) 趋近0时,SInc 就趋近2。这正是最初提出、后来发展为 SuperMemo 的间隔重复技术中,直觉上所假设的稳定性增长。此外,当 P_(r) 较低、r>2 时,SInc 的逐次下降,也对应 SuperMemo 中 R 因子的幂下降。
总之,Anderson 针对记忆强度提出的主张,应针对稳定性,而非可提取性。应该测量并分析连续复习中的稳定性,而不是研究遗忘曲线。发现遗忘呈指数形式,不应削弱 Anderson 的主张。
不过,有一个观察,部分瓦解了以上简化模型,切断记忆与环境之间的直接联系,那就是间隔效应。显然,记忆不愿把环境刺激流当成泊松过程,不把单个事件视为独立,而会考虑事件在时间上的聚集。这是为了防止一簇概率上相关的事件,在建立稳定性的能力上,等同于数量相同的一串独立事件。
Anderson 的主张,必将成为理解记忆的可靠指引。完全阐明环境与记忆的联系,只是时间问题。区分 S 与 R,应能极大帮助避免长期记忆两种属性叠加造成的混淆。
5 记忆衰减函数呈负指数形式
虽然人们一直怀疑遗忘本质上呈指数形式,但证明从不简单。从放射性衰变到木材干燥,指数衰减在生物与物理系统中普遍出现:只要预期衰减数量与样本大小成正比,而且单个粒子衰减概率恒定,就会如此。自艾宾浩斯时代以来[Ebbinghaus,1885],以下问题阻碍了遗忘建模:
- 样本量小;
- 样本异质;
- 混淆学习曲线家族中的遗忘曲线、重新学习曲线、练习曲线、节省曲线、达到掌握所需尝试次数曲线、错误曲线等。
利用 SuperMemo,可以克服这些障碍,研究记忆衰减的本质。作为流行的商业应用,SuperMemo 几乎能无限获取来自世界各地学生的大量数据。每位用户都能查看遗忘曲线图,路径为 Tools : Statistics : Analysis : Forgetting curves,即“工具:统计:分析:遗忘曲线”。它们根据相对均质的样本绘制,真实反映记忆随时间衰减,而不是其他学习曲线形式。不过,追求样本一致性,会显著影响样本量。 必须注意,稳定性与知识难度不同,遗忘曲线也不同。稳定性影响衰减速度,异质学习材料则产生多个不同衰减速度的曲线叠加。因此,即使学习过程涉及数十万条独立信息,也只能筛出相对较小的均质样本,通常不超过几千次复习。即便如此,这些数据的质量,也远超在受控条件下研究记忆特性的研究者所能获得的样本。不过,遗忘的随机性,仍使人难以最终确定衰减函数的数学本质,见下面两个例子。分析数十万个样本后,我们比以往更接近证明:遗忘是一种指数衰减。
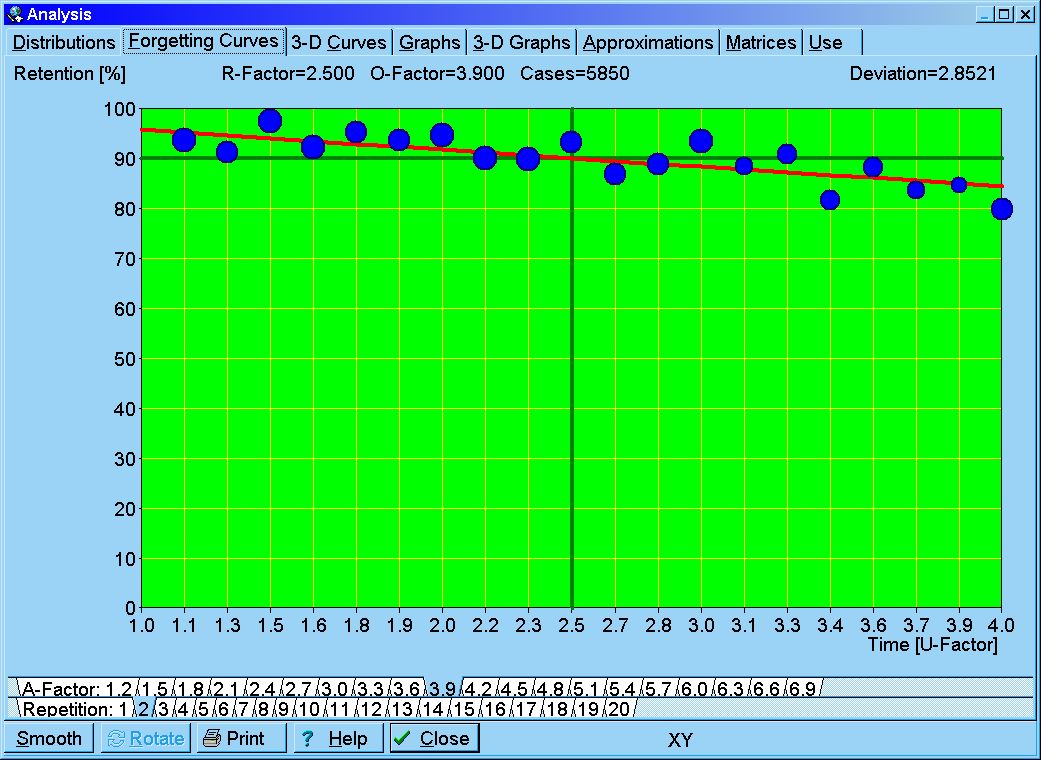
图5.1:SuperMemo 绘制的遗忘曲线示例。从近一百万次复习的数据库样本中,筛出平均难度、较低稳定性的记录,A 因子为3.9,S 在[4,20]内,得到5850次复习,不到总样本的1%。红线是用 R=e^(-kt/S) 回归分析的结果。用其他初等函数拟合,表明指数衰减最符合数据。图中时间度量,是所谓 U 因子,定义为当前复习间隔与上一次间隔之比。注意,R 从1到0.9的范围内,指数衰减可以合理地近似为直线;如果是幂函数,就不会如此。
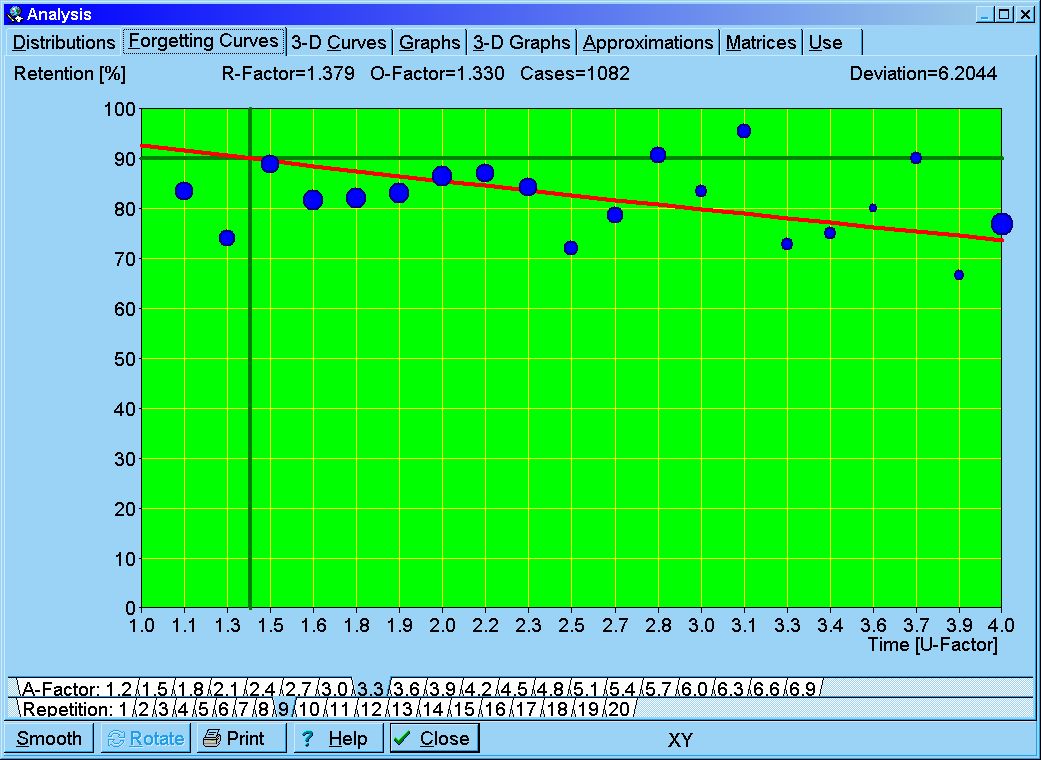
图5.2:SuperMemo 绘制的遗忘曲线示例。从近一百万次复习的数据库样本中,筛选平均难度、中等稳定性的数据,A 因子为3.3,S 大于一年,得到1082次复习。红线是用 R=e^(-kt/S) 回归分析的结果。
为了说明均质样本对研究遗忘曲线的重要性,看看把难知识与易知识混合,会怎样影响曲线形状。图5.3 表明,异质样本为什么可能使人对遗忘本质得出错误结论。这个示例中的异质样本,竟然用幂函数近似最好!指数遗忘曲线经过平均,会呈现幂曲线,这一点此前已有其他人报告[Anderson 与 Tweney,1997;Ritter 与 Schooler,2002]。
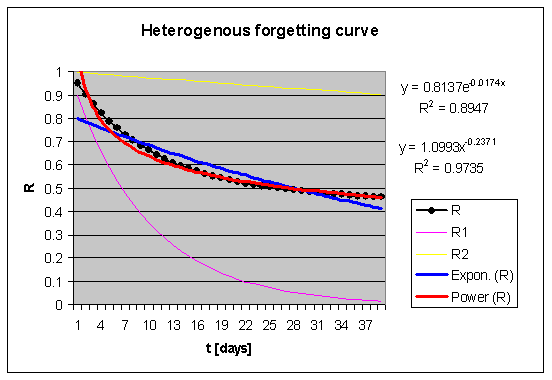
图5.3:遗忘曲线叠加,可能掩盖遗忘的指数性质。构造一个包含两类记忆痕迹的理论样本:50%的稳定性 S=1,用细黄线表示;另50%的 S=40,用细紫线表示。叠加曲线自然有可提取性 R=0.5*R_(a)+0.5*R_(b)=0.5*(e^(-k*t)+e^(-k*t/40)),在图中显示为黑色颗粒线。粗蓝线为指数近似,R²=0.895;粗红线为同一曲线的幂近似,R²=0.974。这个例子中,尽管两个子样本的遗忘都呈负指数,整体却用幂函数拟合最好。
6 复习使记忆稳定性增加的幅度
此前,我们还无法提出把一次复习与稳定性增加联系起来的通用公式。作者提出的复习间隔算法[Wozniak、Gorzelanczyk,1992],基于对使用所谓最佳复习间隔时,稳定性如何增加的一般理解;最佳间隔定义为能产生已知回忆率,通常超过90%,的间隔。“最佳”指它适合学习使用。这些算法,也能用矩阵形式确定最佳间隔对应的准确稳定性增长函数。不过,低可提取性,也就是间隔不最佳时,稳定性如何增加,过去所知甚少。 借助 SuperMemo 收集的数据,现在可以尝试填补空白。虽然 SuperMemo 设计为使用最佳间隔,现实中用户却常因假期、疾病等原因,被迫推迟复习。因此,几乎每组材料,都包含相当数量可提取性较低的复习。另外,2002年 SuperMemo 引入间隔中途复习的概念,使缩短间隔成为可能。虽然中途复习在数据中的比例很小,但只要样本足够大,极低和极高可提取性的复习数量,应该足以把0.9水平上的稳定性增长发现,推广到整个可提取性范围。
要通过学习,以最佳方式建立稳定性,需要知道最佳间隔函数,或稳定性增加函数 SInc。它们有三个自变量:稳定性 S、可提取性 R,以及知识难度 D。传统上,SuperMemo 一直关注 S 与 D,因为计算间隔时,优化程序的首要标准,是保持较高可提取性。这种关注由稳定性增长函数的实际应用决定。 本文转而关注 S 与 R,尝试通过分析“纯知识”,也就是描述易学知识的非复合记忆痕迹,消除 D 维度。消除难度,让理论探讨更容易,结论以后可扩展到复合痕迹与较难知识。换句话说,从实践转向理论时,我们把兴趣从 (S,D) 移到 (S,R)。因此,本文所有数据集都按条目难度筛选:SuperMemo 的 A 因子在3.0至3.5之间,以平衡较多知识条目与较多复习次数。同时,尽量寻找大数据集,其中因延迟复习、偏离最佳间隔而产生的低可提取性条目,要有足够多的代表。
下面介绍一个两步程序,用于在难度低且一致的数据集中,提出描述不同可提取性水平下稳定性增加的符号公式。这些就是表述良好、容易保持的知识数据集。表述良好且一致的材料,使人容易提炼出通过复习进行长期记忆巩固的纯粹过程。正如本文其他地方讨论的,表述不良的知识,会使独立巩固过程叠加,不适合这项分析。
确定稳定性增长函数 SInc 的两步程序:
- 第一步:用矩阵表示 SInc,通过迭代,使实际学习得分与 SInc 预测得分之间的偏差 Dev 最小。Dev 定义为某个知识点一系列复习中 R−Pass 的总和;R 是可提取性,得分及格时 Pass 为1,不及格时为0。
- 第二步:用爬山算法求解最小二乘问题,评估 SInc 的候选符号公式,寻找与第一步得到的矩阵最匹配者。
先定义一个程序,根据给定练习模式计算稳定性。它既能根据已知学习得分计算,称为实践版本,也能只根据复习时间安排计算,称为理论版本。唯一区别,是实践版本允许根据不及格得分反映的随机遗忘,修正稳定性。
下面使用以下记号:
- S(t):时刻 t 的记忆稳定性;
- S[r]:第 r 次复习后的稳定性,例如 S[1] 是初次学习某个知识点后的稳定性;
- R(S,t):稳定性为 S、时间为 t 时的可提取性,已知 R=exp(-k*t/S),k=ln(10/9);
- SInc(R,S):可提取性为 R、稳定性为 S 时,一次练习造成的稳定性增加,满足 SInc(R(S,t),S(t))=S(t”)/S(t’)=S[r]/S[r-1]。t’ 与 t” 分别代表练习时、巩固前后的时刻,t”−t’ 可视为0。
目标是找到适用于任意有效 R、S 水平的稳定性增长函数:SInc=f(R,S)。
如果能找到 SInc(R,S),并设 S[1]=S_(1),其中 S_(1) 是根据首次接触复习后的衰减函数、针对最佳复习间隔得到的稳定性,那么对任意复习历史,都能通过以下迭代计算 S:
r:=1; S[r]:=S_(1) repeat t:=Interval[r]; / Interval[r] 来自实际学习过程,即实践版本, / 或来自所研究的复习模式,即理论版本。 Pass:=(Grade[r]>=3); / Grade[r] 为第 r 个间隔后的得分,即实践版本; / 理论版本中取4。 R:=Ret(S[r],t); if Pass then S[r+1]:=S[r]*SInc[R,S[r]] r:=r+1; else begin r:=1; S[r]:=S_(1); end; until (r 为最后一次复习) 注意,SuperMemo 使用首次间隔图确定 S_(1),每次不及格后,它都会缩短。以后应使用这个更精确的 S_(1) 度量,以提高准确性。
第一步:求出矩阵形式的 SInc
如果从未知矩阵 SInc[R,S] 开始,例如把所有元素任意设为2,见公式4.8,就能把上述程序用于已有复习历史,计算使偏差 Dev=R−Pass 最小的 SInc[R,S]。依据如下:
- 如果 Pass=true 且 S[r]<Interval[r],那么矩阵元素 SInc[R,S[r-1]] 被低估,可以朝 Interval[r]/S[r]*SInc[R,S[r-1]] 修正。
- 如果 Pass=false 且 S[r]>Interval[r],那么矩阵元素 SInc[R,S[r-1]] 被高估。
无论初始化时给 SInc[R,S] 什么值,这种方法都能得到相同的最终矩阵。用于从 SuperMemo 复习历史计算矩阵的应用与源代码,可以向作者索取。 第二步,将利用这里的矩阵,求出 SInc 的符号公式。
第二步:求出符号公式形式的 SInc
现在可以使用任何梯度下降算法,评估 SInc 的候选公式,找出最符合上述矩阵的一个。
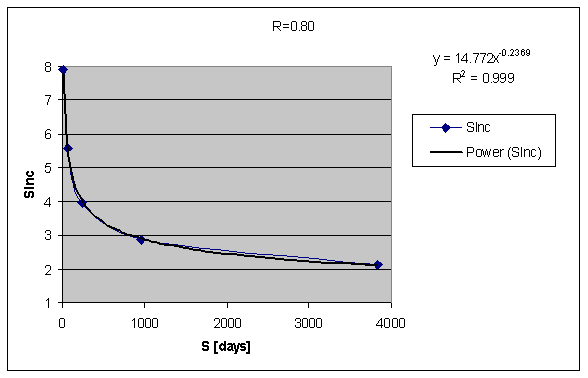
检查矩阵,立即会发现:R 恒定时,SInc 关于 S 的函数,非常适合用负幂函数描述,如下面的数据集示例:
同一图的双对数版本,显示得更清楚:
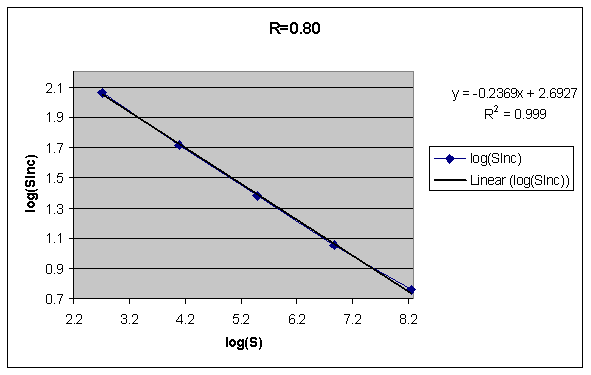
SInc 与 S 呈幂关系的结论,印证了以前的发现。尤其是,SuperMemo 中 R 因子随复习类别下降,一直是用幂函数近似最好。
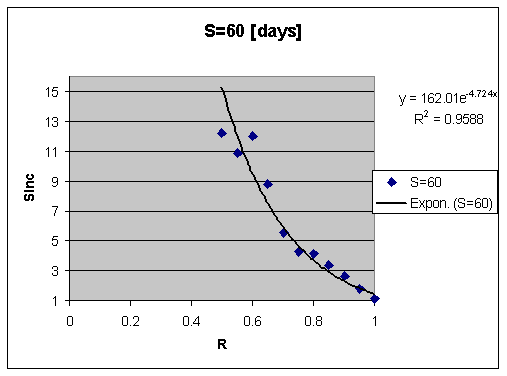
寻找 S 恒定时 SInc 与 R 的关系,会看到更多噪声,因为 SuperMemo 在低 R 区域提供的记录少得多,算法通常试图达到 R>0.9。不过,检查多个数据集后,我们得出了一个有些意外的结论:R 下降时,SInc 呈指数增加,后文会说明,这怎样产生 SInc 与时间近乎线性的关系。增加幅度高于预期,为间隔效应的力量提供了进一步证据。这个结论应对学习策略产生重大影响。
下面是 S 恒定时 SInc 关于 R 的函数的示例数据集。可以看到,SInc(R) 能用负指数函数相当好地近似:
同一图的半对数版本,将线性近似趋势线的截距设为1:
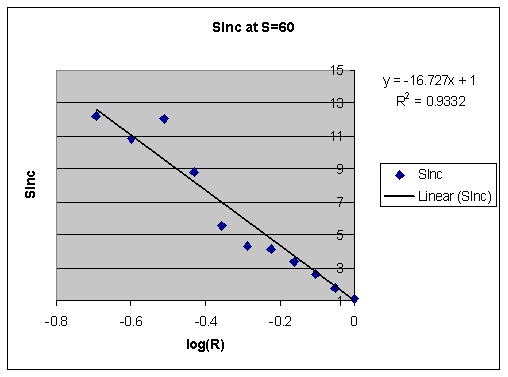
有趣的是,可提取性为100%时,稳定性增长可能小于1。某些分子研究指出,复习时记忆的不稳定性会增加。这进一步说明,反复死记硬背的危害,不只是浪费额外时间。
7 记忆稳定性增加的符号公式
知识难度恒定时,需要用二维曲面拟合,得到 SInc 的符号公式。我们采用修改后的 Levenberg–Marquardt 算法,测试若干可能准确描述 SInc 关于 S、R 关系的候选函数。算法加入持续随机重启循环,以确保找到全局最大值。最佳结果由以下公式得到:
- (7.1) SInc=aS^(–)^(b)*e^(cR)+d;
其中:
- SInc:一次复习造成的稳定性增加,即复习前后稳定性 S 的比值;
- R:复习时的可提取性,以百分比回忆概率表示;
- S:复习前稳定性,以产生 R=0.9 的间隔表示;
- a、b、c、d:不同数据集可能略有不同的参数;
- e:自然对数的底。
a、b、c、d 在不同数据集之间略有变化,可能反映用户与知识互动的差异。也就是说,不同用户面对不同材料,会产生不同难度分布,以及不同评分标准,这些都会影响最终测量。
举例来说,几个数据集的平均参数为:a=76、b=0.023、c=-0.031、d:=-2。其中 c 的跨数据集变化较小,a 与 d 的变异相对较大。
上述公式得到的 SInc,与均质数据集的 SInc 矩阵结果,平均相差15%。这里的均质,指按单个学生、单种知识、低难度、较窄 A 因子范围筛选的复习历史。
随着复习间隔增加,尽管时间经历双重指数运算,SInc 却沿着近乎线性的 S 形曲线增加,因为两个负指数运算相互抵消:
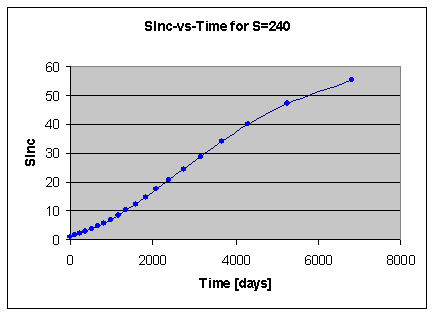
图7.1:SInc 随时间变化的图。采用公式7.1,在 S=240 时生成。
SInc 与时间近乎线性的关系,在 SuperMemo 中体现为:用 O 因子乘实际采用的复习间隔,计算新最佳间隔,而不是乘先前算出的最佳间隔。SuperMemo 的 O 因子,是二维矩阵 OF[S,D] 的元素,代表 R=0.9 时的 SInc。
8 不同可提取性下,记忆稳定性增加的期望值
定义记忆稳定性增加的期望值为:
- (8.1) E(SInc)=SInc*R
其中:
- R:可提取性;
- SInc:公式7.1所定义的稳定性增加;
- E(SInc):考虑概率后的稳定性增长期望,即 SInc 定义的增长,被遗忘削减后的结果。
由公式7.1,得 E(SInc)=(aS^(–b)*e^(cR)+d)*R。求导 dE(SInc)/dR,并令其为0,就能找到不同稳定性水平下,使期望增长最大的可提取性。图8.1 展示 S<15 时,E(SInc) 关于 R 的图。用 SuperMemo 用户熟悉的术语说:短间隔中,稳定性增长的最大期望,出现在遗忘指数为60%时!这也意味着,SuperMemo 允许的最高遗忘指数20%,产生的稳定性期望增长,比最大可能值低近80%,前提是我们愿意牺牲高保持率。
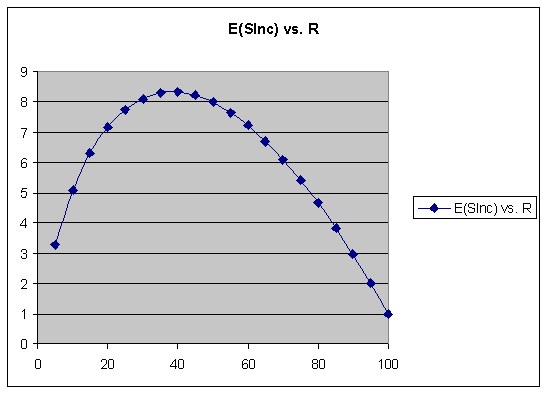
图8.1:稳定性 S<15 时,稳定性增长期望 E(SInc) 关于可提取性 R 的函数。
9 知识复杂度影响遗忘速度
我们认为,学习难度由所记信息的复杂度决定。复杂知识产生两个效应:
- 与其他信息的干扰增加;
- 复习时,难以均匀刺激记忆痕迹的各个子成分。
在学习中采用合适的知识表征,可以对抗这两个难度来源。
看看知识复杂度,怎样影响稳定性的建立。
设想要学习:玛丽·斯克沃多夫斯卡—居里,是1911年诺贝尔化学奖的唯一获奖者。有两种方法:保留复杂知识,或采用简单表述。复杂版本中,为记住姓名与获奖年份,可以设计双挖空:
- 问:[……]是[……]年诺贝尔化学奖的唯一获奖者。
- 答:玛丽·斯克沃多夫斯卡—居里,1911。
简单版本中,把双挖空拆开,把波兰娘家姓设为可选,并另做第三个挖空:
- 问:[……]是1911年诺贝尔化学奖的唯一获奖者。
- 答:玛丽·(斯克沃多夫斯卡—)居里。
- 问:玛丽·斯克沃多夫斯卡—居里,是[……]年的诺贝尔化学奖唯一获奖者。
- 答:1911。
- 问:玛丽·[……]—居里,是1911年诺贝尔化学奖的唯一获奖者。
- 答:斯克沃多夫斯卡。
此外,要完整学习,简单版本还需要两个挖空,因为玛丽·居里也是1903年诺贝尔物理学奖得主,还获得过其他奖项:
- 问:玛丽·斯克沃多夫斯卡—居里,是1911年诺贝尔[……]奖的唯一获奖者。
- 答:化学。
- 问:玛丽·斯克沃多夫斯卡—居里,是1911年[……]的唯一获奖者。
- 答:诺贝尔奖,化学奖。
现在考虑原来的复合双挖空。为便于论证,假定记住1911与居里这个名字一样难。复合痕迹,也就是整个双挖空,的可提取性,是两个子痕迹可提取性的乘积。这来自一个一般规律:大多数情况下,记忆痕迹很大程度上相互独立。虽然忘掉一个痕迹,可能增加忘掉另一个的概率,但经验表明,绝大多数情况下,同主题中分开且不同的问题,可以有完全独立的学习过程,回忆与遗忘彼此无法预测。看看把回忆概率视为独立事件,怎样影响复合痕迹的稳定性:
- (9.1) R=R_(a)*R_(b)
其中:
- R:二元复合记忆痕迹的可提取性;
- R_(a) 与 R_(b):两个独立记忆子成分,也就是子痕迹 a、b 的可提取性。
- (9.2) R=exp(-kt/S_(a))*exp(-kt/S_(b))=exp(-kt/S)
其中:
- t:时间;
- k:ln(10/9);
- S:复合记忆痕迹稳定性;
- S_(a) 与 S_(b):子痕迹 a、b 的稳定性。
- (9.3) -kt/S=-kt/S_(a)-kt/S_(b)=-kt(1/S_(a)+1/S_(b))
- (9.4) S=S_(a)*S_(b)/(S_(a)+S_(b))
后续分析复合痕迹时,将使用公式9.4。可以预期,如果最初子痕迹稳定性 S_(a)、S_(b) 相差很大,那么以最大化 S 为目标,也就是以 R=0.9 为标准,安排后续复习,可能因时机不佳而削弱子成分的稳定性。下一节说明,实际并非如此。
10 复合记忆痕迹的子稳定性会收敛
前文已见 R=exp(-k*t/S)。如果制作双挖空,不能确定一次复习是否均匀激活了存储两条知识的两个记忆回路。假定首次复习是两条痕迹唯一的差异来源,其余学习过程都遵循上述公式。
为研究以 R=0.9 为标准、针对复合稳定性优化的练习模式下,子痕迹稳定性如何变化,设:
- S_(a)=1
- S_(b)=30
- S=S_(a)*S_(b)/(S_(a)+S_(b)),由公式9.4;
- SInc=aS^(–b)*e^(cR)+d,由公式7.1;
- 复合痕迹在 R=0.9 时通过练习得到巩固,并保证两个子痕迹同等地再巩固,也就是复习整体时,不忽略任何子痕迹。
如图10.1,复合痕迹的稳定性,始终小于单个子痕迹,不过,子痕迹的稳定性会收敛。
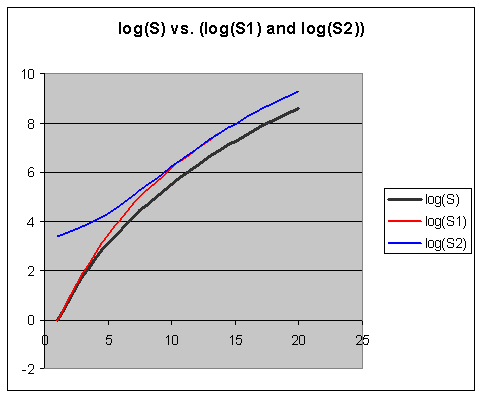
图10.1:采用针对整个复合痕迹优化的同一复习模式,也就是复合可提取性达到0.9时复习,各子痕迹稳定性收敛。横轴为复习次数,纵轴为稳定性的对数。蓝线与红线,是初学后稳定性差异很大的两个子痕迹;黑线是复合稳定性,S=S_(a)*S_(b)/(S_(a)+S_(b))。如果每次复习都均匀激活底层突触结构,S_(a) 与 S_(b) 的差异就会自行修正。
11 复合稳定性的增加,等于子痕迹稳定性的增加
现在考虑,复合稳定性 S 与子痕迹稳定性 S_(a)、S_(b) 的 SInc 相差多少。如果假定对子痕迹的刺激相同,并把 SInc_(a)、SInc_(b) 记为 i,那么第 r 次复习时,有:
- SInc_(a)=SInc_(b)=i
- S_(a)[r]=S_(a)[r-1]*i
- S_(b)[r]=S_(b)[r-1]*i
- S[r]=S_(a)[r]*S_(b)[r]/(S_(a)[r]+S_(b)[r])=
- =S_(a)[r-1]*S_(b)[r-1]*i^(2)/(S_(a)[r-1]*i+S_(b)[r-1]*i)=
- =i*(S_(a)[r-1]*S_(b)[r-1])/(S_(a)[r-1]+S_(b)[r-1)=i*S[r-1]
换句话说:
- (11.1) SInc=i=SInc_(a)=SInc_(b)
以上说明,在本模型中,只要各子痕迹同等再巩固,稳定性的增加,就不依赖知识复杂度。
12 基于稳定性与可提取性区分的分子记忆模型
在分子层面,区分两者,可能有助于解决某些看似矛盾的问题,例如“安帕金类能改善记忆吗?”如果安帕金类激活 AMPA,可能提高可提取性,却恶化 NMDA 解除阻断与记忆巩固的条件。因此,可能看似矛盾地改善回忆、损害学习。S/R 模型的区分,是这类分析的核心。多数记忆研究涉及短时间尺度,只会产生与 R 有关的结果,更凸显模型对理清实验矛盾的重要性。
下面展示 S/R 模型对建立长期记忆分子模型的价值。使用长期记忆双成分模型提出的指导原则[Wozniak、Gorzelanczyk、Murakowski,1995]:
- R 应与回忆概率相关;遗忘应理解为 R 降到0。
- 第一次复习后,R 就应达到高值,随后在几天内迅速下降。
- S 决定 R 下降的速度;稳定性越高,可提取性下降越慢。
- 每次复习,S 都增加,R 下降得更慢。
- S 只有经过较多复习,才应达到高值。
- 复习间隔中,S 不应显著变化。
- R 很高时,复习不会显著影响 S,这就是间隔效应。
- 只有有效复习,也就是间隔足够长之后的复习,才增加 R 与 S。
- 遗忘应使 S 降到0。
依据 S/R 指导原则的长期记忆模型示例
变量:
- R 是 AMPA 的磷酸化程度。
- S 是插入膜中的 AMPA 受体数量。
指导原则,参见 Wozniak、Gorzelanczyk,1998:
- 磷酸化 AMPA 改善神经传递,因此回忆更好。
- 学习时,经 NMDA 流入的钙,激活包括 CaMKII 在内的级联反应,导致 AMPA 磷酸化;起初,自发去磷酸化很快。
- 膜中插入的 AMPA 越多,磷酸化 AMPA 越稳定,可能通过突触后致密区 PSD 的结构变化实现;去磷酸化更慢。
- 膜的稳定性变化,使更多 AMPA 稳定整合;每次有效复习,都提高稳定性。
- 突触在稳定状态存活越久,每次复习就会更进一步稳定。
- 没有回忆时,AMPA 去磷酸化逐渐降低 R,但 AMPA 仍留在膜中,稳定性变化不大。
- AMPA 磷酸化程度高时,突触容易传递;由于超极化,NMDA 的镁阻断不能解除,因此稳定性不增加。只有去磷酸化降低 R,也就是降低 AMPA 传递时,NMDA 镁阻断才能解除,再通过钙电流增加稳定性。
- NMDA 解除阻断时,新的 AMPA 整合入膜,并充分磷酸化,使可提取性最大。合成更多 AMPA 受体,也可能发挥作用。
- S 越高,通过 PSD 结构变化进一步增加它,就越容易。
总结
- 用使可提取性达到0.9的复习间隔表示稳定性,有助于进一步开展富有成果的理论研究。
- 稳定性可以反映环境中事件再次出现的概率。不过,间隔效应使人不能把事件出现视为泊松过程。
- 每次后续复习,稳定性的增加幅度都更小。把环境事件视为泊松过程,可以解释这一点。出现率低时,泊松过程预测的首次复习稳定性增幅趋近2。
- 遗忘是一种负指数衰减。SuperMemo 收集的大数据集支持这一观察。样本小、异质,解释了其他研究者为什么可能得到不同结论。此外,并非所有学习曲线,都能表示可提取性。
- 稳定性越高,练习造成的稳定性增加越小;关系用负幂函数表示。
- 可提取性越低,练习造成的稳定性增加越明显;关系似乎最好用负指数函数表示。
- 找到了描述练习所致稳定性增加的符号公式。SuperMemo 收集的大数据,使这项发现成为可能。公式可能为长期记忆建模打开广阔前景,也让没有编程背景的研究者能进入这一领域。
- 练习造成的稳定性增加,取决于练习时间。时间与增幅呈 S 形关系,但实际应用中,在有限时间范围内,可以很好地用线性函数近似。
- 稳定性增长的期望,定义为可提取性与稳定性增幅之积,在可提取性约0.4时最大。
- 二元复合记忆的稳定性,可以由子痕迹稳定性计算:S=S_(a)*S_(b)/(S_(a)+S_(b))。由更多子痕迹构成的复合记忆,也能推导类似公式。
- 如果子痕迹同等再巩固,它们的稳定性会在复习过程中收敛。
- 如果子痕迹同等再巩固,复合痕迹的稳定性增加,等于各子痕迹的增加。
- S/R 记忆模型,有助于解析长期记忆分子基础研究中的矛盾发现。
参考文献:
- 《记忆中环境的反映》;Anderson, J. R., & Schooler, L. J. (1991). Reflections of the environment in memory. Psychological Science, 2, 396 – 408
- 《作为涌现属性的幂律》;Anderson, R. B. (1997). The power law as the emergent property. Bowling Green State University.
- 《遗忘中人为产生的幂曲线》;Anderson, R. B., & Tweney, R. (1997). Artifactual power curves in forgetting. Memory & Cognition, 25,724-730
- 《记忆:对实验心理学的贡献》;Ebbinghaus H. (1885). Memory: A Contribution to Experimental Psychology
- 《学习曲线》;Ritter, F.E., & Schooler, L. J. (2002). The learning curve. Encyclopedia of the Social and Behavioral Sciences. 8602-8605
- 《配对联想学习中复习的最佳安排》;Wozniak, P.A., Gorzela?k, E.J. (1992). Optimal scheduling of repetitions in paired-associate learning. Acta Neurobiologiae Experimentalis, Vol. 52, p. 189
- 《长期记忆的两个成分》;Wozniak P.A, Gorzela?k, E.J., Murakowski J. (1995). Two components of long-term memory. Acta Neurobiologiae Experimentalis, Vol. 55, p. 301-305
- 《长期记忆双成分模型的假设性分子对应物》;Wozniak P.A, Gorzela?k, E.J., (1998). Hypothetical molecular correlates of the two-component model of long-term memory. Symposium of the Polish Network of Molecular and Cellular Biology